

如何把网页喂给LLM?
在构建基于大模型的智能应用时,我们都面临一个核心挑战:模型本身不具备获取实时信息的能力。无论是回答最新事件,还是解析特定网页内容,直接依赖模型的内部知识都存在时效性风险与事实性“幻觉”。
数眼智能Web Reader API旨在成为您应用架构中的标准化信息获取层。当查询需要外部信息时,只需要通过一个简单的API调用,将任意网页URL转化为纯净、结构化的文本数据。
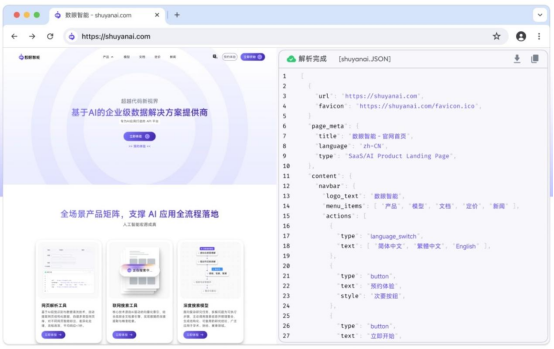
测试不同环境的网页解析功能
为应对大模型上下文有限、长文本处理效率不高的挑战,精准提取网页核心内容并排除噪声是关键。数眼智能网页阅读API能精准提取公众号、各类官网、论坛等页面的正文、表格等信息,并转换为适合大模型处理的Markdown等结构化格式。
其优势在于对国内主流平台的深度优化。通过定制内核与智能代理网络,有效绕过反爬限制,实现高效、稳定的内容抓取。
我们看看实操如何?
常规官方网站
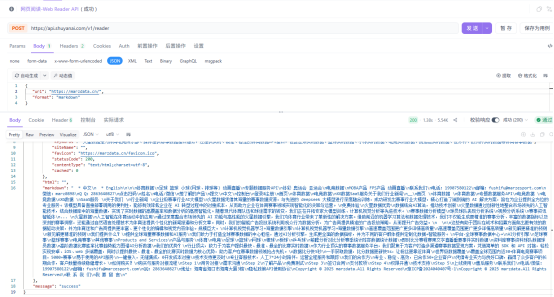
原文地址:https://www.marzdata.cn/
数眼智能官方网站
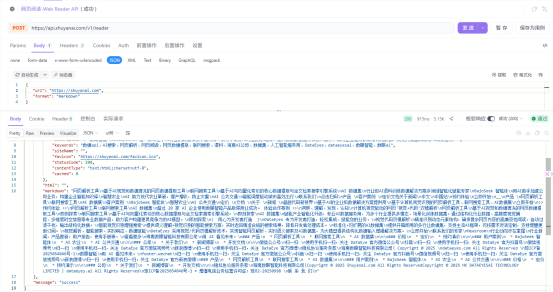
原文地址:https://shuyanai.com/
核心工作流:三步实现从网页到AI就绪数据
该API将复杂的网页信息处理封装为一条高效、稳定的自动化流水线:
智能获取与渲染:无缝处理各类现代网页,包括依赖JavaScript动态渲染的复杂单页应用(SPA),确保获取内容的完整性与准确性。
精准解析与净化:基于先进的机器学习模型,智能识别并剥离广告、侧边栏等噪声,精准提取核心正文、标题、作者、发布时间等元数据,并保留表格、列表、代码块的内在逻辑结构。
结构化输出:提供面向AI优化的输出格式,特别是清晰的Markdown或结构化的JSON。这使得提取的内容无需二次清洗,即可直接嵌入大模型提示词、存入向量数据库或进行下游分析,极大提升开发效率。
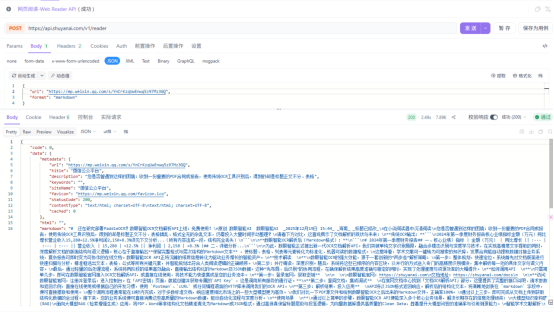
关键应用场景:赋能下一代智能应用
通过提供稳定、高质量的实时信息流,Web Reader API在多个关键场景中发挥着不可或缺的作用:
高质量数据自动处理:为AI模型训练与知识库构建,自动从网页中采集、清洗并输出结构化的Markdown数据,直接作为高质量语料与知识素材,显著提升模型输入质量并降低数据准备成本。
复杂信息精准解析:对搜索结果或新闻、法规等垂直领域页面,能精准提取核心内容并转化为规范格式,为后续的摘要、重写、问答及行业应用提供可直接处理的纯净文本。
开放易集成:作为标准化API,可便捷集成于浏览器插件、AI阅读器等各类上层应用中,充当即插即用的网页解析引擎,赋能开发者快速构建创新工具。
为什么选择数眼智能
数眼智能 Web Reader API 在工程层面提供了可靠保障:
高精度解析:超越基于规则的方法,对网页布局和内容进行语义理解,提取准确度显著提升。
企业级可靠性:具备健壮的错误处理和抗反爬能力,保障商业应用的连续稳定运行。
开发者友好:提供简洁的RESTful API接口、详尽的技术文档及多种语言的SDK示例,支持快速集成与调试。
响应时间小于1秒:毫秒级处理速度,实时输出解析结果,为你的应用提供更流畅的用户体验。
立即开始,连接AI与真实世界
只需获取API Key,即可通过一个简单的HTTP调用开始使用。数眼智能 Web Reader API 致力于成为连接大模型与广阔、动态互联网的关键桥梁。
我们诚邀广大开发者集成体验,用它来构建更智能、更实时、更值得用户信赖的新一代AI应用。让您的产品,真正拥有感知现实世界脉搏的能力。