

大模型越来越便宜,企业的AI账单却越来越高。钱到底花在了哪里?又该怎么省下来?数眼智能以模型接入、治理、计量一站式基础设施,帮企业把AI成本算明白、管到位。
如果说 2023 年是大模型的 "诞生之年",2024 年是 "应用爆发之年",那么 2026 年正在成为"成本觉醒之年"。
越来越多的企业发现:AI 不是用不起,而是用得糊涂。一个高调用量的应用,每月 Token 账单可能因模型选择、调用方式和治理水平的不同而产生数倍差距,而很多企业甚至说不清钱具体花在了哪里。
本文从第一性原理出发,解析 Token 经济学的底层逻辑,并给出企业落地的思考方向。
一、Token:AI 世界的 "电"
Token 是大模型处理文本的基本单位。1 个 Token 约等于 0.75 个英文单词,约等于 0.6 到 1 个中文字 —— 不同模型的分词器存在差异,国产模型通常 1 个 Token 对应约 1 个中文字,OpenAI 系列约 0.6 个。
它同时是四层价值的载体:对模型公司而言是收入单位,每处理 1 个 Token 产生一次计费;对基础设施商而言是算力单位,1 个 Token 的生成消耗一定量的 GPU 算力;对开发者而言是成本单位,每次调用的费用等于输入 Tokens 乘以输入单价加上输出 Tokens 乘以输出单价;对终端用户而言是体验单位,输出 Tokens 越多,回答越长越详细。
理解了这四层关系,就能理解价格为什么这样变动,以及成本优化的空间在哪里。
二、成本的底层逻辑
一次推理的成本可以用一个公式概括:
单次推理成本 =(预填充算力 + 生成算力)× GPU 时薪 ÷ GPU 利用率
其中GPU 利用率是成本差异的最大变量。不同的资源调度策略会产生不同的利用率 —— 低延迟优先的策略会预留更多空闲算力,利用率相对较低;高吞吐优先的策略通过动态调度和批处理提升利用率,单位成本更低。这也是不同服务商价格差异的核心来源之一。
另外两个反直觉的规律值得注意。
第一,输入越长,边际成本越高。 预填充阶段的计算量与输入长度的平方相关,输入从 1000 Token 增加到 4000 Token,预填充计算量增加约 16 倍。这就是长上下文模型价格远高于普通模型的原因。
第二,输出比输入贵。 生成阶段是逐字进行的,每个输出 Token 都需要一次完整的前向传播,而预填充可以批量并行处理。以 GPT-4o 为例,输出价格恰好是输入价格的 4 倍。
三、价格崩塌:三年大幅下降
大模型 API 价格的下降速度远超预期,经历了三次关键驱动。
第一次发生在 2024 年初,由开源模型冲击驱动。 Llama 3、Mistral 等开源模型的发布,让 "自己部署模型" 成为可能,自部署成本大幅低于当时的闭源 API 价格,倒逼整个行业降价。
第二次发生在 2025 年中,由推理优化技术成熟驱动。 投机解码(Speculative Decoding)用小模型生成草稿、大模型一次验证,生成速度提升 2 到 3 倍;PagedAttention 借鉴操作系统分页思想管理 KV 缓存,显存利用率大幅提升;连续批处理(Continuous Batching)通过动态批次调度让 GPU 不空等,利用率从约 40% 提升到 70% 以上。这些技术叠加,让单次推理成本大幅下降。
第三次发生在 2026 年第一季度,由国产模型高性价比进入市场驱动。 DeepSeek、Qwen、GLM 等国产模型以极具竞争力的价格杀入市场,进一步拉低了 API 调用的价格门槛。
以 2026 年 9 月的主流模型输入价为例,轻量模型约每百万 Token 0.15 到 0.30 美元,中端模型约 0.50 到 1.50 美元,旗舰模型约 2.00 到 3.00 美元。不同梯队模型之间存在数倍价差,为企业按任务选型提供了充足的空间。
三次降价叠加,2026 年旗舰级推理的单位成本较 2023 年已大幅下降。
四、企业降本:五层思考框架
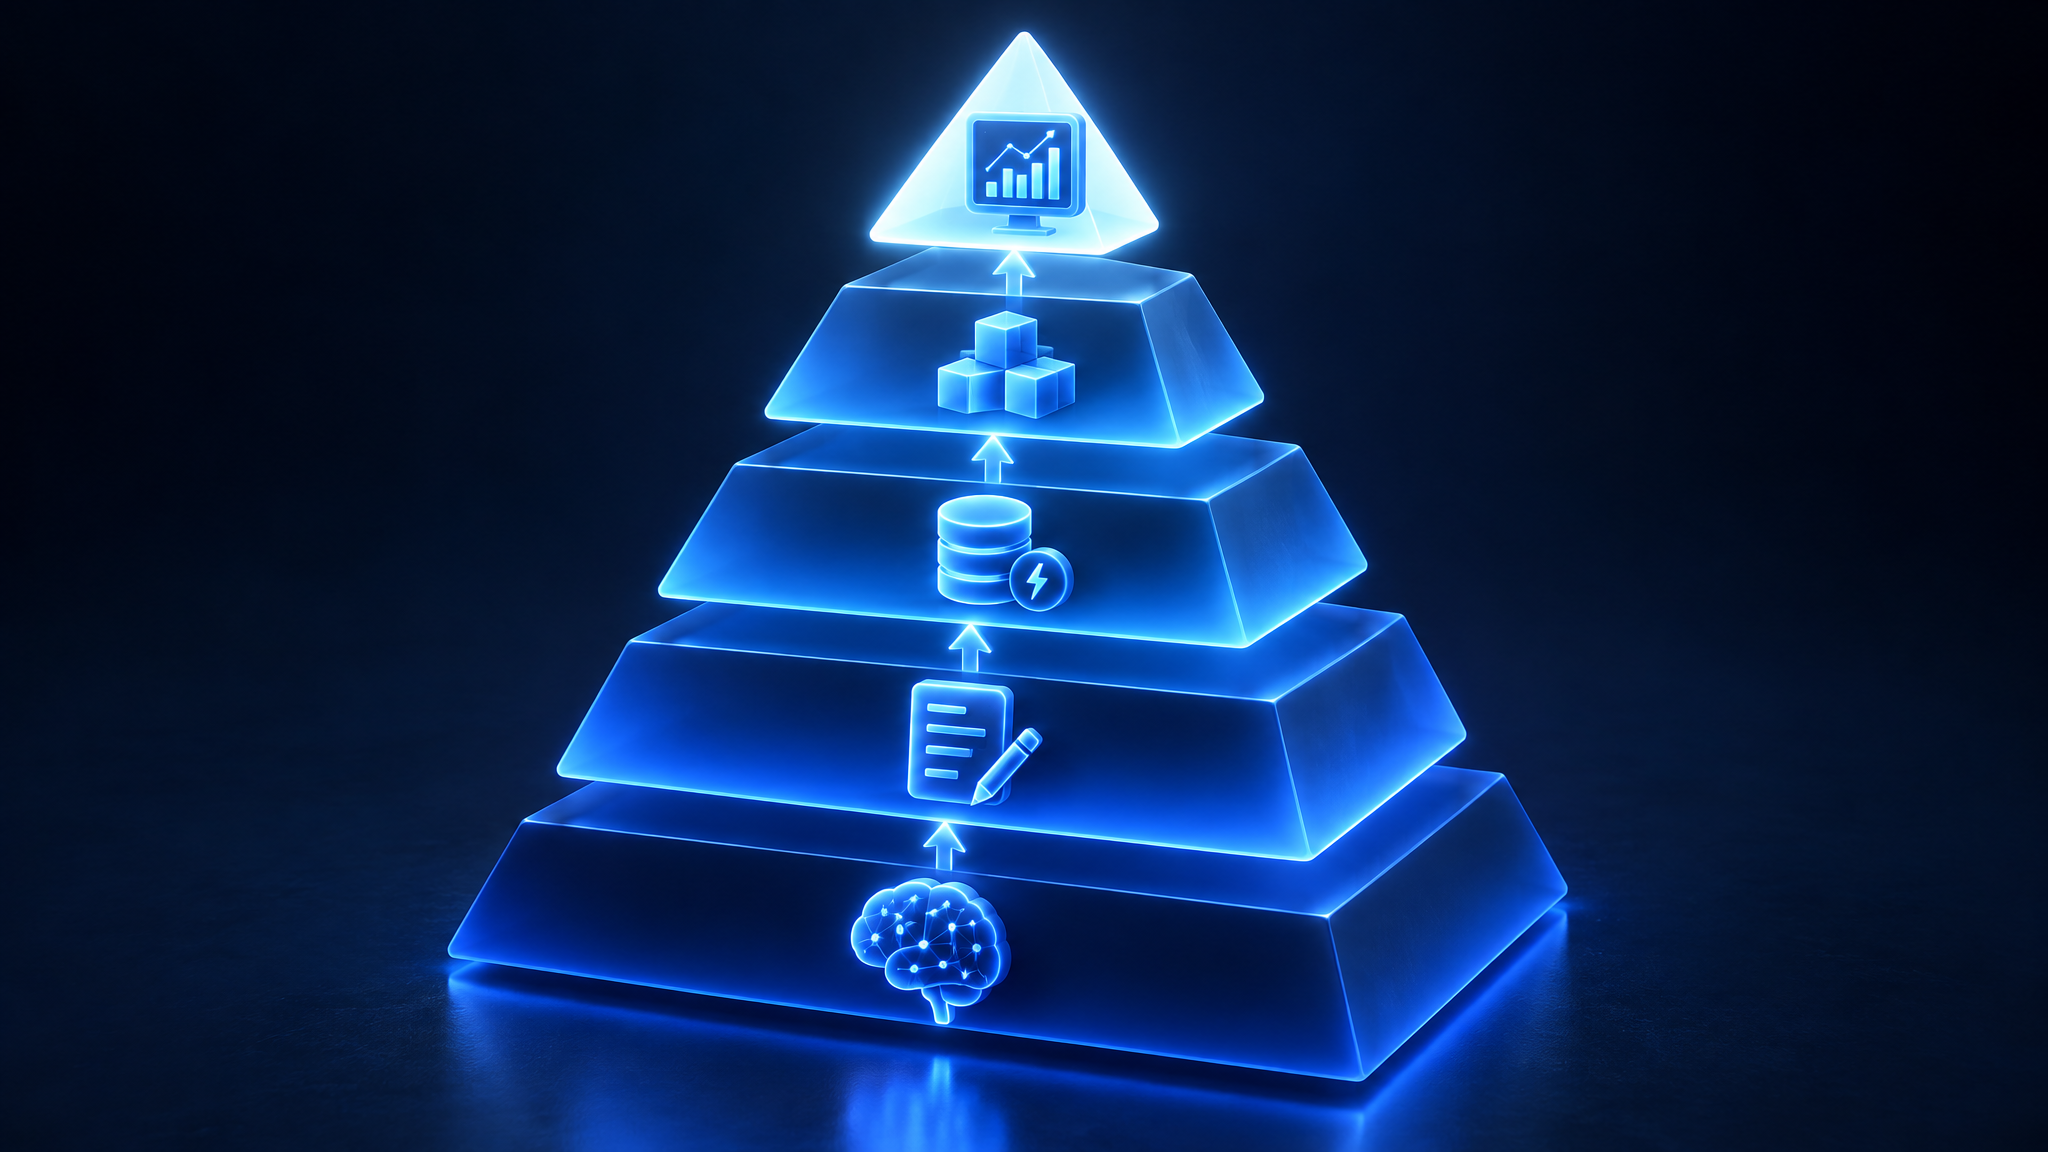
价格在降,但企业 AI 总支出却在涨 —— 因为用量增长的速度往往超过价格下降的速度。系统性降本可以从五个层面思考。
第一层:模型选型。 建立任务复杂度分级,简单任务用轻量模型,复杂任务用旗舰模型。这是投入产出比最高的优化方向,不需要改动架构,只需要在调用前加一层判断。
第二层:Prompt 优化。 精简 System Prompt 中的冗余信息,控制 Few-shot 示例的数量(通常 2 到 3 个足够),合理限制 max_tokens 避免无意义的长输出,使用结构化输出减少解析失败导致的重试。
第三层:缓存与批处理。 对高频重复请求做语义缓存,相似问题直接返回缓存答案;对非实时任务做批量处理,批量推理的单位成本远低于单次调用;利用模型厂商提供的前缀缓存能力,相同的 System Prompt 只计费一次。
第四层:架构优化。 RAG 场景先检索再生成,减少输入 Token 长度;Agent 场景用小模型做规划、大模型做执行;多轮对话定期压缩历史消息,避免上下文无限膨胀。
第五层:治理与监控。 建立按部门或项目的成本分摊机制,让每个业务线对自己的 AI 成本负责;设置异常用量告警,突然飙升的调用量可能意味着 bug 或攻击;定期复盘成本最高的接口,针对性优化。
以上各层的降本幅度为行业经验估算,实际效果因业务场景而异。但核心问题是:这套框架的每一层,都需要一个稳定、灵活的基础设施来支撑。
五、数眼智能:企业级 AI 服务的基础设施
在 Token 成本日益成为企业关注焦点的背景下,数眼智能致力于为企业提供模型接入、治理、计量的一站式基础设施服务,帮助企业在 AI 落地过程中实现成本可控、稳定可靠、管理透明。
多模型接入:让选型有更多选择
降本的前提是有得选。数眼智能提供多模型聚合接入能力,覆盖主流的通用大模型、多模态模型和 Embedding 模型,企业无需在多个平台间分别对接和维护,通过统一的接入方式即可灵活调用不同模型。
平台兼容主流的 API 调用格式,降低了企业的接入和迁移成本,让 "按任务选模型" 从理念变为可落地的实践。
智能调用策略:让模型匹配更智能
数眼智能在 2.4 版本中上线了 API 调用策略功能,支持企业根据自身业务需求配置模型调用规则,实现更灵活的模型调度和流量管理。
企业可以基于业务场景特点,制定适合自己的调用策略,在成本、质量和稳定性之间取得平衡。具体的策略配置方式和能力范围,以数眼智能控制台的实际功能为准。
透明计量与治理:让成本看得见
降本的前提是知道钱花在了哪里。数眼智能提供完善的用量计量和成本分析能力,帮助企业清晰了解 AI 调用的用量和费用情况。
平台支持多维度的用量查询和统计,企业可以按不同维度查看和分析 AI 调用成本,建立精细化的成本管理机制,让 AI 支出从 "糊涂账" 变成 "明白账"。
稳定可靠:让业务不中断
再便宜的模型,服务不可用就是零。数眼智能注重服务稳定性建设,通过多线路接入和故障转移机制,降低单一模型或单一线路故障对业务的影响,保障企业 AI 应用的持续运行。
安全合规:让企业用得放心
数眼智能重视数据安全和合规能力,为企业提供安全可靠的 AI 调用服务。平台支持企业级的权限管理和访问控制,并可根据企业需求提供相应的部署方案,满足不同行业的安全合规要求。具体的安全能力和部署选项,以官方产品说明为准。
从模型接入到调用策略,从用量计量到稳定保障,数眼智能围绕企业 AI 落地的核心需求,提供一站式的基础设施服务,帮助企业在 AI 时代实现用得起、用得稳、用得透明。
🚀 了解更多
访问数眼智能官网 www.shuyanai.com,了解产品详情和最新动态。
新用户注册可体验平台全部功能,开启你的企业 AI 降本之路。
六、结语:成本不是问题,成本意识才是
大模型的成本还会继续下降。但当 AI 变得足够便宜时,它的使用量会爆炸式增长,总成本反而会更高 —— 就像电力成本降了 100 倍,人类总用电量却增长了 1000 倍。
真正的竞争优势,不在于你用了多贵的模型,而在于你是否建立了精细化的 AI 成本管理能力。
Token 经济学的革命,本质上是一场效率革命。而效率,永远是商业世界最硬的通货。